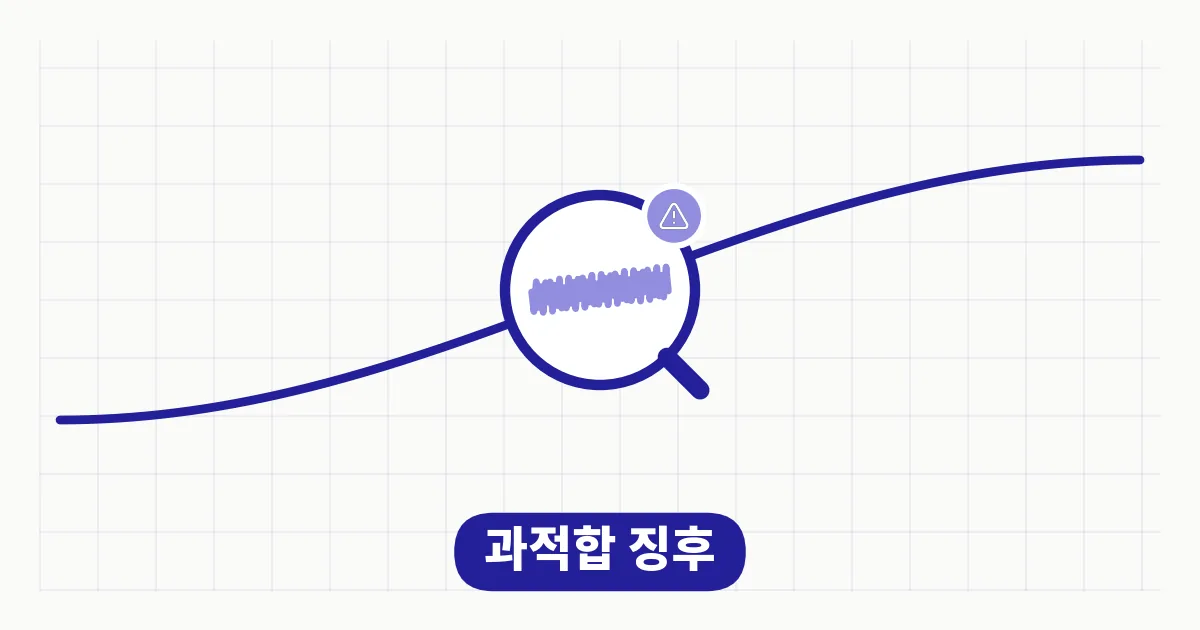
백테스트를 돌렸더니 연 30%씩 나던 전략이 있었다고 해보겠습니다. 조건을 조금씩 손보니 수익률이 계속 좋아지고, 마침내 그래프가 거의 직선으로 우상향하는 결과를 얻었어요. 그런데 이 전략을 실제 계좌에 넣는 순간 성과가 뚝 떨어지는 일이 정말 흔하게 벌어집니다.
이게 바로 과적합입니다. 과적합이란 쉽게 말해 과거 데이터에는 완벽하게 들어맞지만, 새로운 데이터(미래·실전)에는 통하지 않는 상태를 뜻합니다. 백테스트란 무엇이고 왜 하는지 이해했다면, 이제는 그 백테스트 결과를 그대로 믿어도 되는지 의심해볼 차례인데요. 오늘은 이 과적합이 왜 일어나는지, 어떤 근거로 다들 이걸 조심하라고 하는지를 다룹니다.
과적합이란 무엇인가 — 시험 문제만 외운 학생
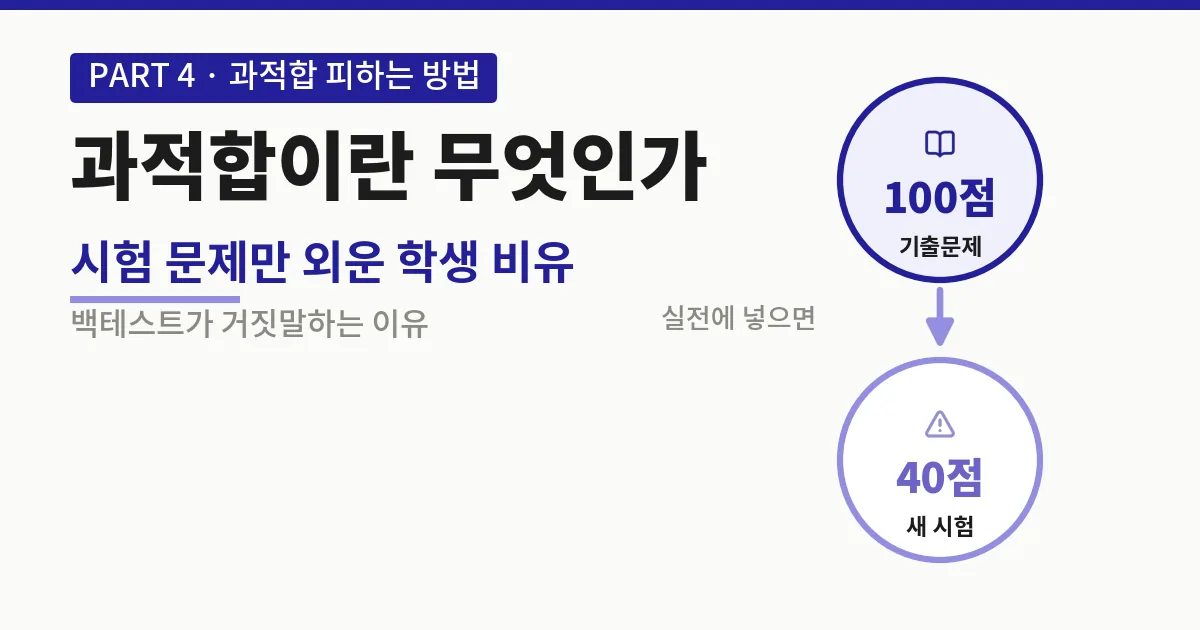
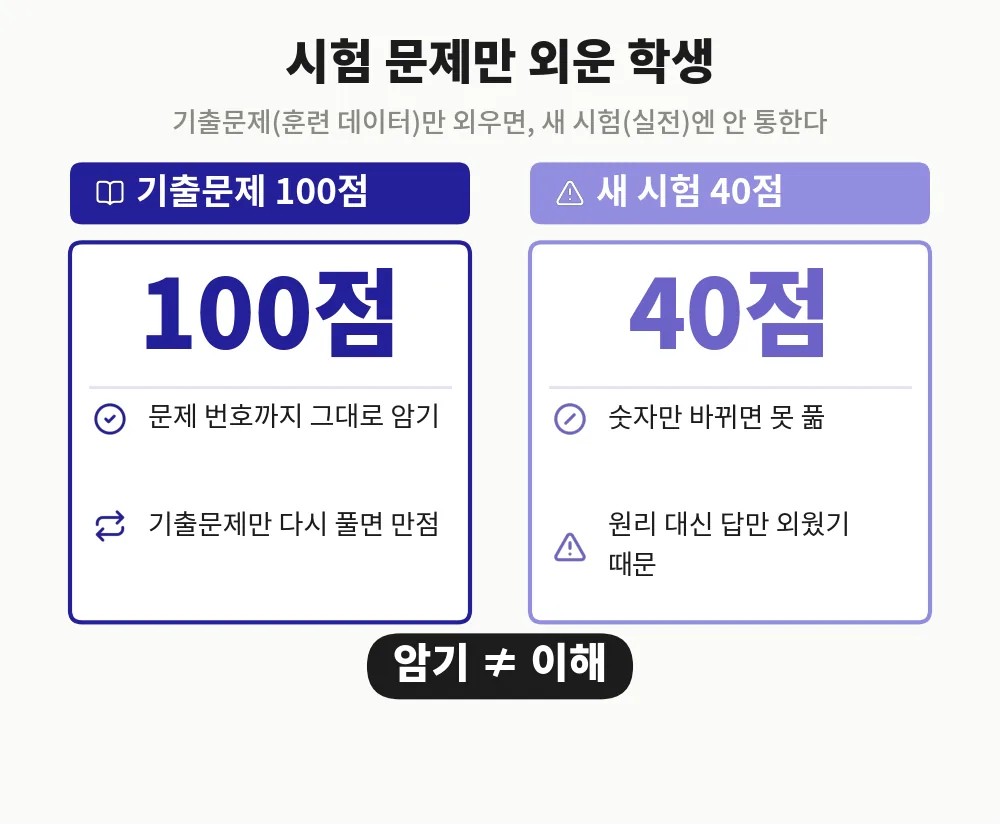
가장 쉬운 비유는 시험 문제라고 생각합니다. 어떤 학생이 기출문제 100개를 완벽하게 외웠다고 해볼게요. 문제 번호와 답을 그대로 매칭해서 외웠기 때문에, 그 기출문제만 다시 풀면 100점이 나옵니다.
그런데 정작 실제 시험에서는 숫자만 바뀐 비슷한 유형의 문제가 나오는데도 이 학생은 40점을 받습니다. 문제를 “이해”한 게 아니라 “답을 외운” 것이기 때문이죠. 원리를 배운 게 아니라 특정 문제의 특정 답을 암기한 겁니다.
퀀트 전략도 똑같은 구조로 무너집니다. 과거 5년 치 주가 데이터(기출문제)에 맞춰 진입 조건, 이동평균 기간, 손절 비율 같은 파라미터(암기한 답)를 계속 조정합니다.
그러다 보면 어느 순간 그 5년 구간에서만 기가 막히게 맞아떨어지는 조합을 찾게 되는데요. 이 조합은 “시장의 원리”를 찾은 게 아니라 “그 5년의 우연한 패턴”을 외운 것에 가깝습니다. 그래서 실전이라는 새 시험에 넣으면 성과가 붕괴하는 겁니다.
오버피팅 뜻 — 머신러닝과 투자에서 조금 다르게 쓰인다
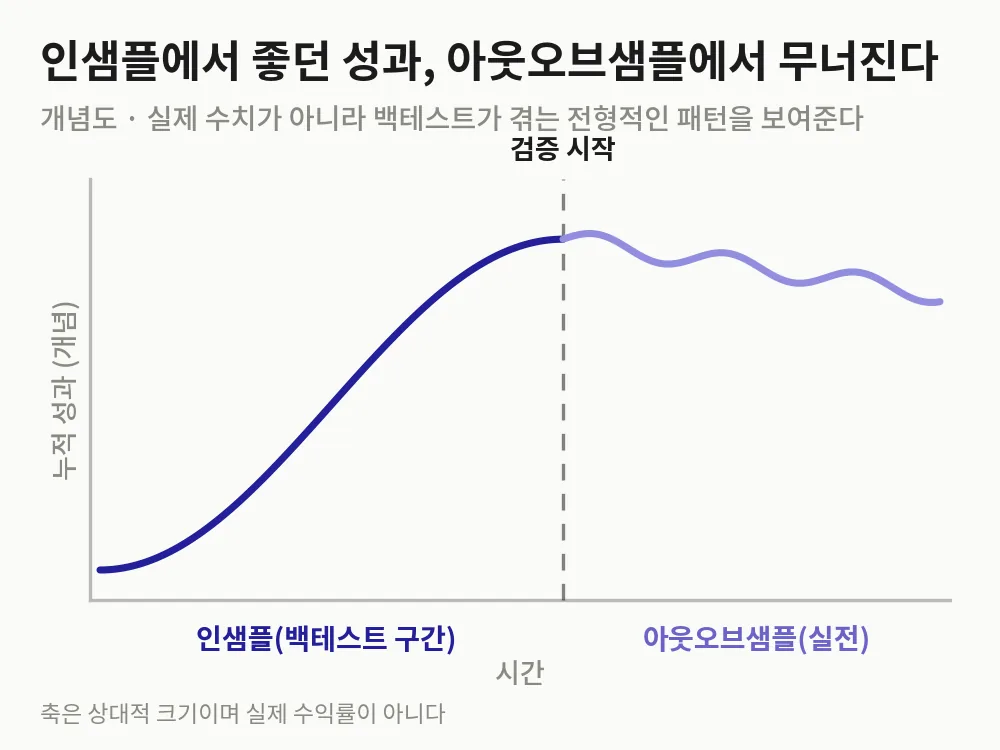
과적합은 영어로 오버피팅(overfitting)이라고 부릅니다. 오버피팅 뜻은 원래 머신러닝 분야에서 먼저 쓰이던 말인데요. 모델이 훈련 데이터에서는 성능이 계속 좋아지는데 검증 데이터에서는 오히려 나빠지는 현상을 가리킵니다.
투자 백테스트에서는 이 “성능”이라는 말이 수익률, 샤프지수(수익 대비 위험을 얼마나 효율적으로 감수했는지 보여주는 지표), 최대낙폭 같은 지표로 바뀔 뿐 구조는 똑같습니다. 훈련 구간(인샘플)에서는 성적이 좋아지도록 파라미터를 조정하고, 검증 구간(아웃오브샘플)에서는 그 성적이 재현되는지를 봅니다.
문제는 아웃오브샘플 구간에서 성과가 재현되지 않는 경우가 압도적으로 많다는 겁니다. 인샘플과 아웃오브샘플을 나눠서 검증하는 방법을 이미 다룬 적이 있는데, 그 방법이 필요한 이유가 바로 이 과적합을 걸러내기 위해서입니다.
학술 근거 — 숫자로 보는 과적합
감으로 하는 얘기가 아니라 실제 연구들이 이 현상을 반복적으로 확인했습니다. 몇 가지 짚어볼게요.
McLean과 Pontiff는 2016년 *Journal of Finance*(Vol.71(1), pp.5-32)에 발표한 연구에서 97개의 주식 예측 변수(팩터)를 분석했는데요. 그 결과 아웃오브샘플 수익률이 인샘플 대비 26% 낮았고, 논문으로 발표된 이후 시점의 수익률은 인샘플 대비 무려 58% 낮았습니다(출처: McLean & Pontiff, *Journal of Finance*, 2016). 이게 무슨 뜻이냐면요, 백테스트에서 잘 맞았던 전략은 시간이 지날수록, 특히 남들에게 알려질수록 더 빨리 힘을 잃는다는 겁니다.
Harvey, Liu, Zhu(2016)의 연구는 기준을 아예 높이자고 제안했습니다. 전통적으로는 t-통계량(어떤 결과가 우연이 아닐 가능성을 보여주는 통계 수치)이 2.0을 넘으면 유의미하다고 봤는데, 이 논문은 새로 발견된 팩터라면 t-통계량 3.0을 넘어야 한다고 주장했어요(출처: Harvey, Liu, Zhu, *Review of Financial Studies*, Vol.29(1), 2016). 기준을 올리자는 이유는 간단합니다. 그만큼 우연히 유의미해 보이는 가짜 발견이 많다는 뜻이니까요.
Sullivan, Timmermann, White(1999)는 더 노골적으로 보여줍니다. 이들은 필터 규칙, 이동평균, 지지/저항, 채널 브레이크아웃, 거래량 균형 지표까지 총 7,846개의 기술적 거래 규칙을 통째로 테스트했어요(출처: Sullivan, Timmermann, White, *Journal of Finance*, Vol.54(5), 1999). 그런데 데이터 스누핑(같은 데이터를 계속 뒤져서 우연히 잘 맞는 조합을 찾아내는 행위) 편향을 보정하고 나니, DJIA·S&P500 같은 시장에서 유의미하게 수익성 있는 단순 규칙을 찾지 못했습니다.
CXO Advisory가 정리한 888개 트레이딩 전략 연구도 결이 비슷합니다. 인샘플 성과가 아웃오브샘플 성과를 얼마나 설명하는지 R²(결정계수, 한 값으로 다른 값이 얼마나 설명되는지 보여주는 지표)로 계산했더니 0.01~0.02에 그쳤어요(출처: CXO Advisory / Wiecki et al., 2016). 인샘플 성적표가 실전 성적을 겨우 1~2%밖에 설명하지 못한다는 뜻이니, 백테스트 성과만 보고 실전 성과를 가늠할 근거는 사실상 거의 없다고 봐야 합니다.
이 연구들을 관통하는 얘기는 하나입니다. 알파(초과수익)가 시간이 지나면서 소멸하는 이유를 찾아보면, 그 원인의 상당 부분이 애초에 그 알파가 진짜 원리가 아니라 과적합된 우연이었기 때문인 경우가 많다는 겁니다.
왜 생기나 — 과적합의 흔한 원인들
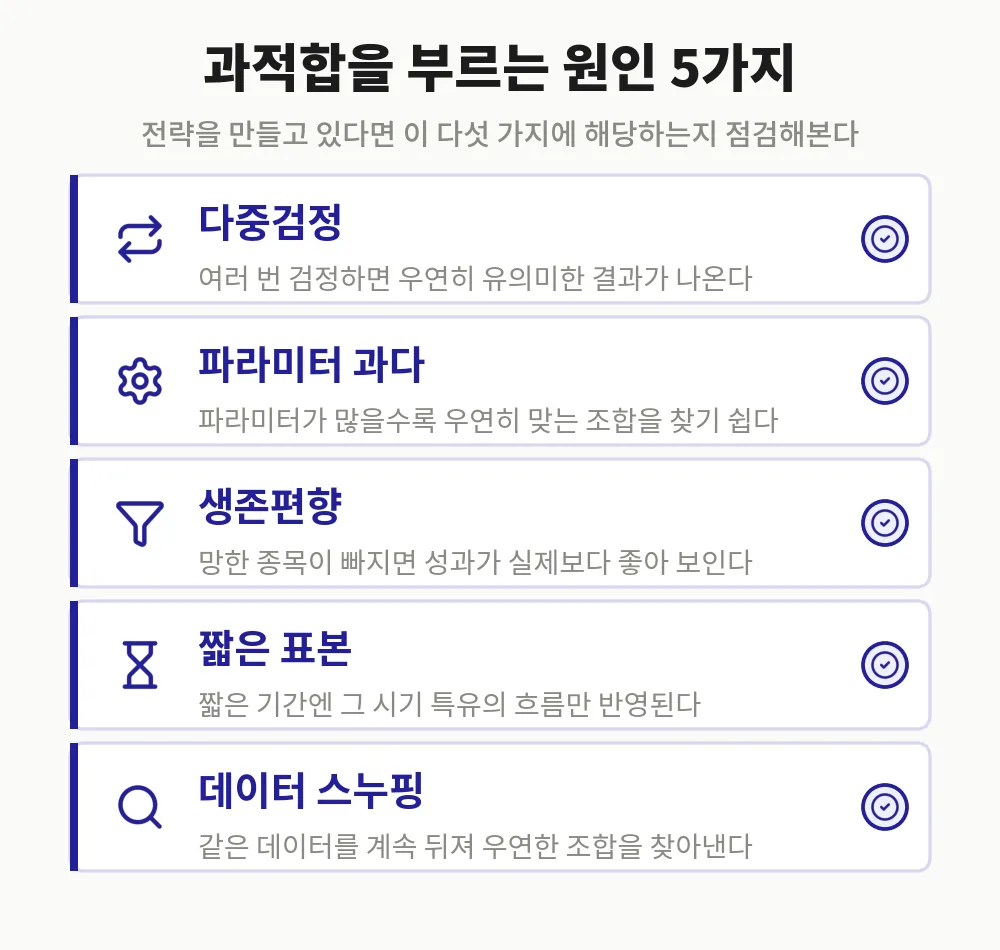
데이터 스누핑과 다중검정
가설을 여러 개 세우고 하나씩 검정하다 보면, 그중 몇 개는 순전히 우연으로 “유의미”하게 나옵니다. p<0.05를 기준으로 가설 20개를 각각 독립적으로 검정한다고 해볼게요.
하나의 가설이 우연히 유의미로 안 나올 확률은 0.95입니다. 20개 전부 우연히 안 나올 확률은 0.95의 20제곱, 계산하면 약 0.3585예요. 그러니 20개 중 최소 1개가 우연히 유의미로 나올 확률은 1에서 0.3585를 뺀 약 64%가 됩니다.
파라미터 조합, 진입 조건, 손절 기준을 이것저것 바꿔가며 20번쯤 테스트했다면 그중 하나는 순전히 운으로 좋은 성과를 낸다는 뜻입니다. 문제는 그 “운 좋은 하나”를 진짜 전략인 줄 알고 실전에 넣는 순간 벌어집니다.
파라미터 자유도
조정할 수 있는 파라미터가 많을수록 위험도 커집니다. Bailey, Borwein, López de Prado, Zhu(2014)의 연구가 이 문제를 정면으로 다뤘어요.
이 논문은 5년 정도의 데이터로 45개 이상의 독립적인 파라미터 조합을 시도하면, 인샘플 샤프지수는 1인데 정작 아웃오브샘플 샤프지수는 0인 전략, 즉 겉으로만 그럴싸한 전략을 찾아내는 게 사실상 확실해진다고 밝혔습니다(출처: Bailey et al., *Notices of the AMS*, Vol.61(5), 2014). 파라미터를 많이 만질수록 우연히 잘 맞는 조합을 만날 기회도 그만큼 늘어난다는 거죠.
생존편향과 짧은 표본
과거 데이터를 쓸 때 지금까지 살아남은 기업·펀드만 데이터에 남아 있는 경우가 있습니다. 망하거나 상장폐지된 종목은 빠져 있으니 성과가 실제보다 좋게 나오는데요. 뮤추얼펀드를 대상으로 한 연구들에서는 이 생존편향이 연 1~2%대(대략 1.4%) 수익률을 과다 계상시킨다고 보고했습니다(출처: Brown, Goetzmann, Ibbotson, Ross, 1992; Elton, Gruber, Blake, 1996).
표본 기간이 짧은 것도 같은 맥락의 문제입니다. 2~3년 치 데이터만으로 전략을 만들면, 그 기간에 우연히 있었던 특정 시장 흐름(예를 들어 특정 업종의 강세)에만 맞는 규칙이 될 가능성이 큽니다. 데이터 마이닝 편향으로 우연한 패턴을 걸러내는 법을 같이 읽어보시면 이 부분이 더 명확해질 것 같습니다.
나도 이러고 있나 — 짧은 자가진단
전략을 만들고 있다면 아래 질문에 스스로 답해보시면 좋겠습니다.
파라미터를 몇 번이나 바꿔가며 백테스트를 돌렸는지 기억하시나요. 만약 열 번, 스무 번씩 조건을 바꿔보며 “이 값이 제일 좋네” 하고 골랐다면, 그 자체가 앞서 말한 다중검정 문제에 걸려 있을 가능성이 있습니다.
전체 데이터 중 얼마를 검증용으로 따로 떼어놓고 안 봤는지도 확인해볼 만합니다. 전체 데이터를 다 써서 파라미터를 최적화했다면 검증할 구간 자체가 없는 셈이니까요.
수익률 곡선이 지나치게 매끈한지도 살펴보시면 좋겠어요. 실전 시장은 원래 울퉁불퉁한데, 백테스트 그래프가 이상하리만치 직선에 가깝다면 오히려 의심해볼 여지가 있습니다. 이런 징후들을 더 자세히 짚는 이야기는 다음 편에서 이어가겠습니다.
과적합은 실력 부족이 아니라 기본값이다
과적합이란 결국 “과거에만 맞는 답을 실전에도 통할 거라 착각하는 것”이라고 정리할 수 있을 것 같습니다. 그런데 이게 초보만 겪는 실수는 아니라는 점을 강조하고 싶어요. 앞서 본 학술 연구들은 전문 연구자들이 발표한 팩터조차 발표 이후 수익률이 크게 줄어든다는 걸 보여줬으니까요.
파라미터를 조정할 수 있고 데이터를 여러 번 들여다볼 수 있는 이상, 과적합은 누구에게나 기본값으로 일어나는 현상에 가깝습니다. 중요한 건 이걸 완전히 없애는 게 아니라 알아채고 줄이는 방법을 갖추는 쪽이라고 생각합니다.
앞으로 이어질 PART 4에서는 과적합의 구체적인 징후를 어떻게 알아채는지, 강건성 테스트로 전략을 어떻게 흔들어보는지, 훈련·검증·테스트 데이터를 어떻게 나눠야 하는지를 차례로 다뤄보겠습니다.
세 줄로 줄이면 이렇습니다. 첫째, 과적합이란 과거 데이터에만 맞고 실전에는 안 통하는 상태입니다. 둘째, 학술 연구들은 인샘플 성과와 아웃오브샘플 성과가 거의 무관할 정도로 다르다는 걸 반복해서 보여줬습니다. 셋째, 파라미터를 적게 쓰고 데이터를 함부로 여러 번 뒤지지 않으며 검증 구간을 반드시 따로 떼어놓는 습관이 그나마 확실한 방어입니다.
※ 이 글은 개인이 공부하며 정리한 기록으로, 특정 상품·종목에 대한 투자
권유가 아닙니다. 모든 투자의 판단과 책임은 투자자 본인에게 있으며,
글의 수치는 작성일 기준이므로 실제 가입·투자 전 최신 정보를 꼭 확인하세요.